近日,我院心理学院陈维教授团队在Nature旗下唯一面向人文社会科学的子刊《Humanities&Social Sciences Communications》在线发表题为“Key predictors of subjective well-being among Chinese people: a multi-wave national cross-sectional analysis using machine learning, 2015–2023”的研究论文。《Humanities&Social Sciences Communications》是Nature旗下唯一面向人文社会科学的子刊,出版人文科学、行为科学和社会科学所有领域的高水平研究,同时被A&HCI与SSCI收录。根据期刊引用指数(JCI),该期刊在人文学科跨学科领域408本期刊中位列第1,在社会科学跨学科领域271本期刊中位列第2,在全球人文社会科学领域具有重要影响力。
该研究聚焦主观幸福感。主观幸福感是个体对自身生活状况的主观评价,能够为公共政策制定提供重要参考。然而,过去理论与实证研究发现影响主观幸福感的因素众多,其相对重要性始终缺乏系统厘清。一个核心问题是:在众多潜在预测因素中,究竟哪些因素对主观幸福感具有最稳健、最关键的预测作用?是收入、社会地位等结构性因素,还是公平感、自评健康状况等个体感知因素?以往研究多依赖于单一波次数据或传统回归方法,难以在众多预测变量中识别出稳定且简约的核心因素集。
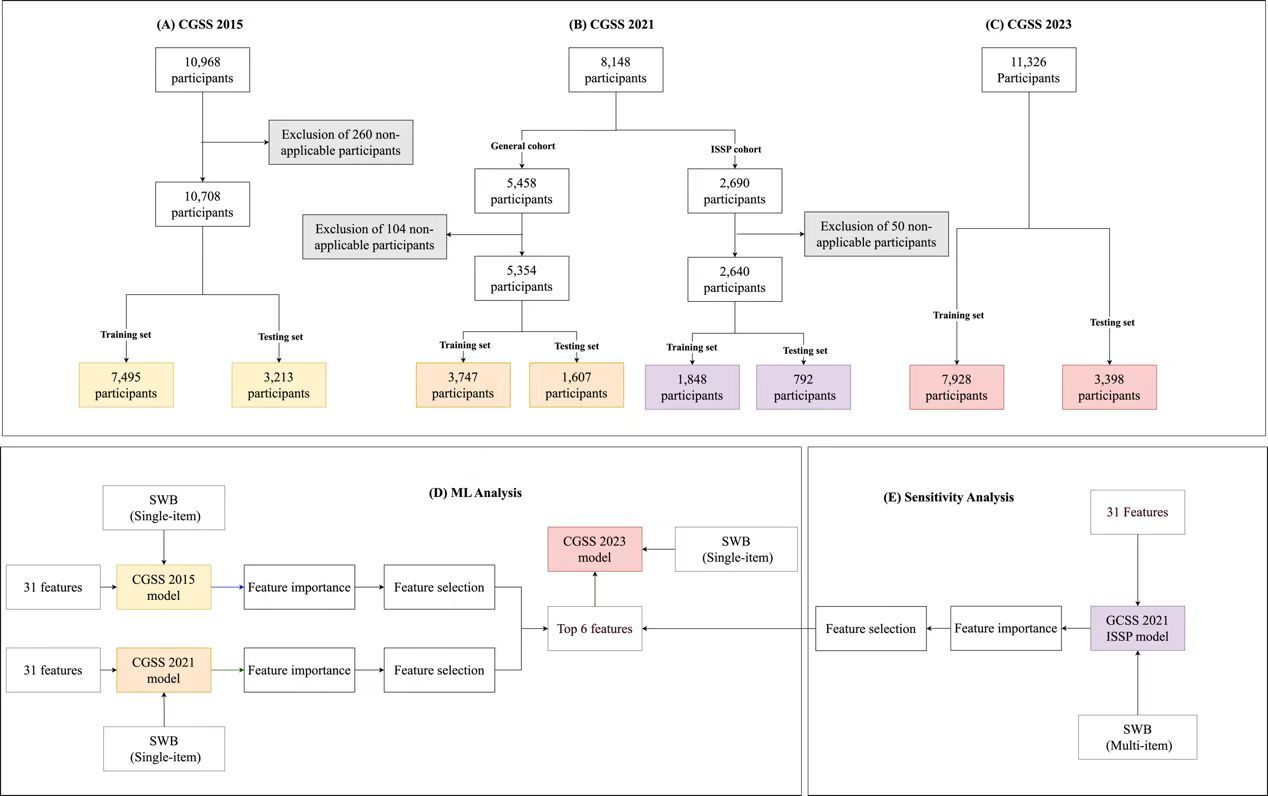
研究过程流程图
研究采用机器学习方法,基于中国综合社会调查2015年(N = 10,968)、2021年(N = 5,458)和2023年(N = 11,326)三期全国性重复横断调查数据,运用XGBoost算法,基于31个预测变量对主观幸福感得分进行建模,系统考察各因素对主观幸福感的预测重要性及其跨波次的稳定性。研究发现,社会公平感、家庭经济状况、抑郁情绪、当前社会阶层、年龄与自评身体健康六项因素在三期调查中均被一致识别为最稳健的核心预测因素。仅使用这六个特征的简化模型在开发样本中即可达到R² = 0.21–0.26,在外部验证中R² = 0.23,保留了完整31个特征模型所解释方差的84.0%–86.7%,表现出跨独立样本的稳定预测性能。基于此,研究提出了一套面向中国人群的简约核心预测因素集,为公共政策制定提供了循证基础,简化模型在政策模拟与决策支持方面也具有实际应用潜力。
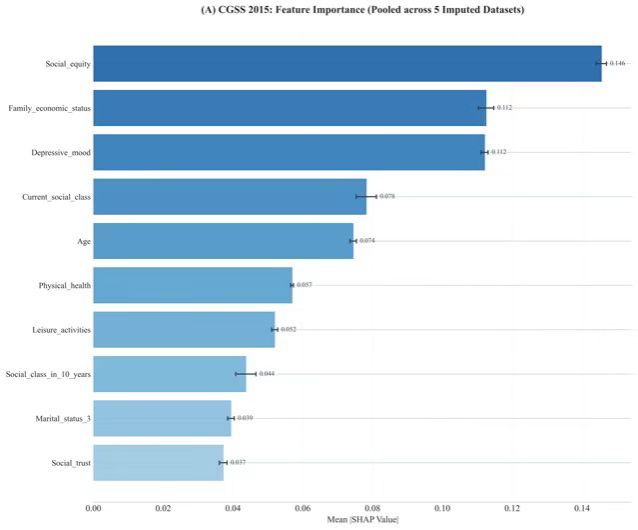
机器学习识别出关于主观幸福感一致的重要预测因素
该论文由陈维教授作为第一作者和通讯作者,心理学院2026级博士研究生肖世胤作为共同第一作者。研究工作得到贵州省哲学社会科学规划项目阶段性成果(25GZZB02)的资助。
论文全文链接:https://doi.org/10.1057/s41599-026-09123-6
一审杨业
二审罗杰
三审李凤